นักเล่น homelab รัน AI โมเดล 2.8 ล้านล้านพารามิเตอร์ด้วย Optane รุ่นที่ 2 ไม่ใช้ GPU
ผู้ใช้ Reddit รายหนึ่งรันโมเดล Kimi K3 ของ Moonshot AI บนแรม Optane PMem 200 ที่เลิกผลิตไปแล้ว ใช้ซีพียู Xeon 40 คอร์ล้วนๆ แต่แลกมาด้วยความร้อนสูงและความเร็วที่ต่ำมาก
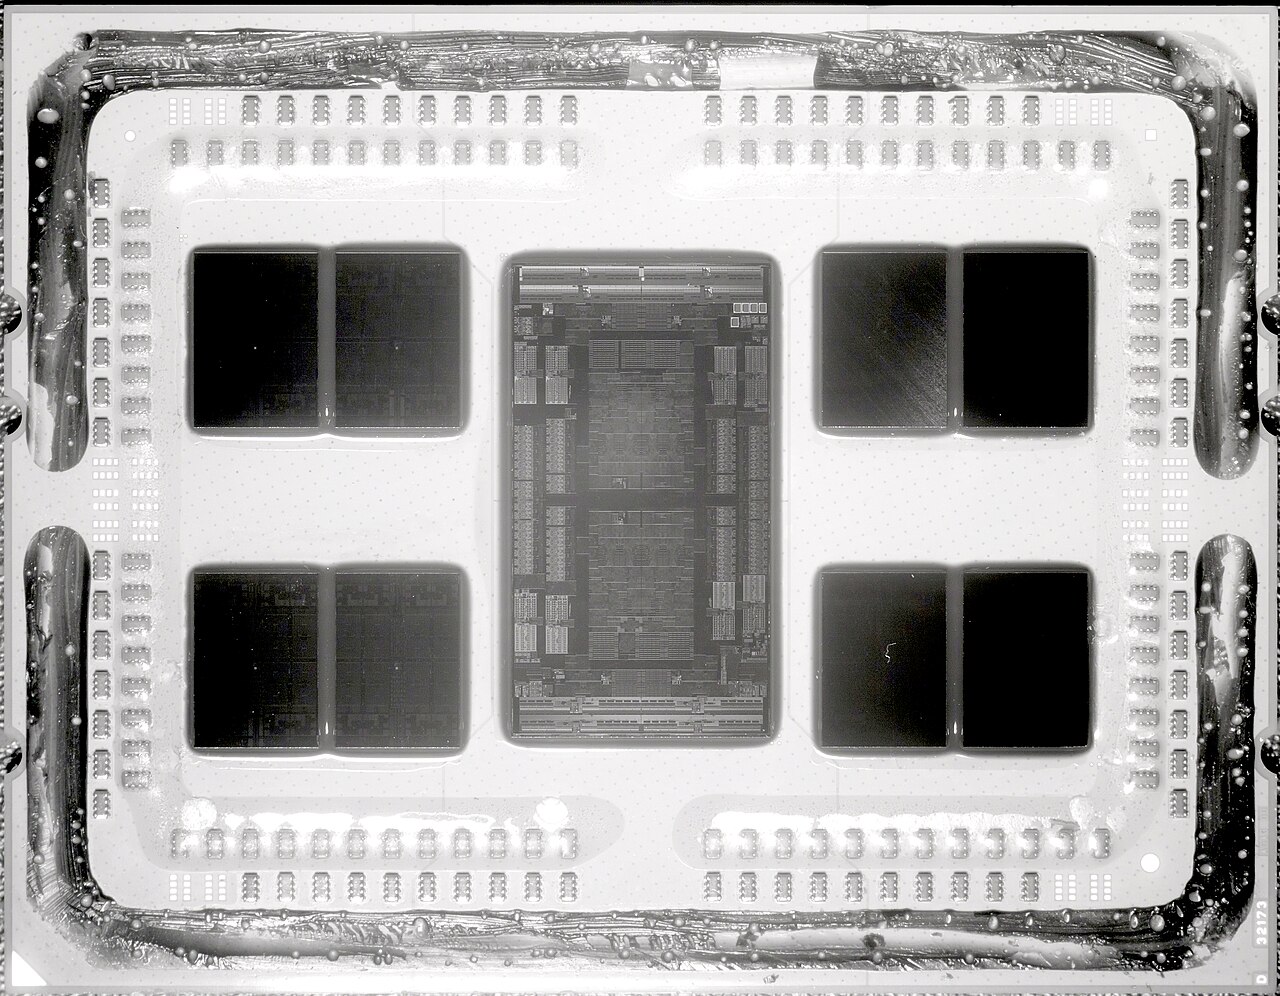
 AI ภาพสร้างด้วย AI ไม่ใช่ภาพถ่ายจริง
มีคนเล่น homelab บน Reddit เอาโมเดล Kimi K3 ของ Moonshot AI ที่มีขนาดใหญ่ถึง 2.8 ล้านล้านพารามิเตอร์ มารันบนแรม Optane Persistent Memory 200 ของ Intel ที่เลิกผลิตไปแล้ว โดยใช้ซีพียู Xeon Scalable รุ่น 3 แบบ 40 คอร์ทำ inference เองโดยไม่พึ่ง GPU เลย
เรื่องนี้น่าสนใจเพราะ Kimi K3 ไม่ได้ถูกออกแบบมาให้รันที่บ้านตั้งแต่ต้น Moonshot AI เองก็แนะนำให้ใช้ engine ระดับ data center แม้แต่เวอร์ชัน quantization เล็กที่สุดก็ยังต้องการแรมอย่างน้อย 610GB การใช้ Optane มือสองจึงเป็นหนึ่งในไม่กี่ทางที่จะไปถึงความจุระดับนี้ได้ที่บ้าน โดยเจ้าของโปรเจกต์บอกว่าราคา Optane ถูกกว่าแรมปัจจุบันมากในช่วงที่ราคา DRAM พุ่งสูง
แต่ของมันแลกกับความเร็ว ผลที่ได้ออกมาอยู่ที่ 0.85 token ต่อวินาทีตอนใช้ quantization แบบ 1-bit และถ้าใช้ quantization 3-bit ความเร็วจะลดลงไปอีกเป็น 0.75 token ต่อวินาที มีคนคอมเมนต์ว่างานขนาด 50,000 token จะใช้เวลาประมาณ 13 ชั่วโมงถ้ารันที่ราว 1 token ต่อวินาที
อีกปัญหาที่หนักคือความร้อน โมดูล Optane ร้อนจัดมากตอนรัน inference ต่อเนื่อง จนเจ้าของโปรเจกต์บอกว่าอาจเป็นอันตรายต่อแรม DRAM ที่อยู่ข้างๆ เขาแก้ด้วยการใช้พัดลมเป่าลม 12W สองตัวเล็งไปที่โมดูลโดยตรง เพราะ Optane รุ่นนี้ทนความร้อนได้ถึง 83 องศาเซลเซียสก่อนจะถูก throttle และดับที่ 85 องศา
โปรเจกต์นี้ต่อยอดจากงานก่อนหน้าของอีกคนที่ใช้ Optane รุ่นแรกกับโมเดล K2.5 ขนาด 1 ล้านล้านพารามิเตอร์ ซึ่งทำความเร็วได้ราว 4 token ต่อวินาทีเพราะมี GPU RTX 3060 ช่วยด้วย ส่วนตัวเลขของโปรเจกต์ล่าสุดนี้ยังเป็นผลก่อนการปรับจูน และเจ้าของโปรเจกต์วางแผนจะเพิ่ม GPU กับโหลดบางส่วนลง DRAM เพื่อให้เร็วขึ้นในอนาคต
ที่มาของข่าว
- สำนักข่าว
- Tom's Hardware
- พาดหัวต้นฉบับ
- Homelabber uses second-gen Optane memory sticks to run a 2.8-trillion-parameter AI model on CPU alone
- เผยแพร่ต้นทาง
- 8 พ.ย. 2569 19:20 น.