Revolut ลดต้นทุน AI ช่วยเขียนโค้ดลง 90% ด้วยการเลิกพึ่ง Claude ไปใช้โมเดลโฮสต์เอง
ฟินเทคอังกฤษเผยหันมาใช้ GLM-5.3 ที่โฮสต์เองบน Nvidia B200 แทนบริการอย่าง Claude ทำให้ต้นทุนถูกลงราว 10 เท่า พร้อมดันประสิทธิภาพงานวิศวกรขึ้นชัดเจน
Revolut ฟินเทคจากอังกฤษบอกว่าในเวลาไม่ถึง 1 ปี สามารถลดต้นทุนการใช้ AI ช่วยเขียนโค้ด (inference cost) ลงได้ราว 90 เปอร์เซ็นต์ ด้วยการเปลี่ยนจากพึ่งบริการอย่าง Claude มาใช้โมเดลที่โฮสต์เองเป็นค่าเริ่มต้นแทน
David Abitbol หัวหน้าฝ่าย ops และ infrastructure ของ Revolut เล่าในงาน AI Engineer conference ที่นิวยอร์กเมื่อเดือนก่อนว่า ก่อนหน้านี้บริษัทกังวลเรื่องต้นทุนมาก เพราะเห็นวิศวกรบางคนใช้เงินไปถึง 1,000-10,000 ดอลลาร์ต่อเดือน แต่ผลตอบแทนไม่คุ้มค่า ตอนเปิดใช้งานจึงต้องตั้งลิมิตงบประมาณเข้มงวด
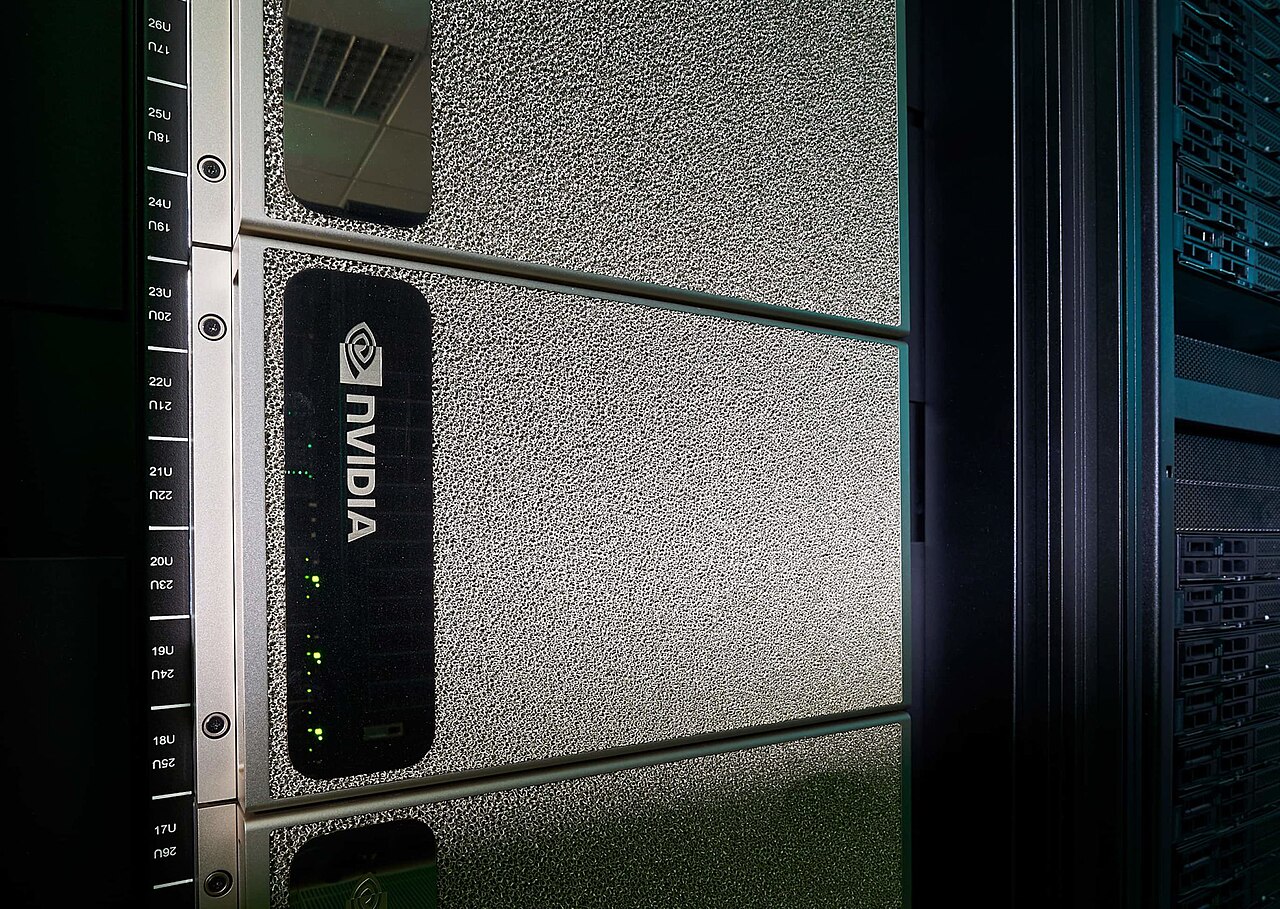
จุดเปลี่ยนคือ Revolut หันมาโฮสต์โมเดลเอง เริ่มจาก GLM-5.1 ก่อนย้ายไป GLM-5.3 ซึ่งรันอยู่บน Nvidia B200 GPU จำนวน 56 ตัว ด้วยราคาประมาณ 0.30 ดอลลาร์ต่อล้านโทเคน ถูกกว่าการใช้ OpenAI Codex หรือ Claude Code ประมาณ 10 เท่า พอโทเคนราคาถูกลง วิศวกรก็กล้าปล่อยให้ AI ช่วยแก้บั๊กหรือจัดการตั๋วงานใน Jira และ Confluence มากขึ้น
ผลลัพธ์คือเวลาเขียนโค้ดดีขึ้น 60 เปอร์เซ็นต์ และ lead time ดีขึ้น 70 เปอร์เซ็นต์ จากการปล่อยเครื่องมือนี้ให้วิศวกรใช้ราว 2,000 คน
บริบทยาวเป็นเรื่องหลอกลวง ต้องระมัดระวังให้ดี ถึงจะรองรับได้ถึง 1 ล้านโทเคน แต่ที่จำเป็นจริงๆคือแค่ 256,000 โทเคน
Abitbol บอกว่าเป้าหมายคือให้ time to first token ต่ำกว่า 3 วินาที และความเร็วสร้างคำตอบราว 200 โทเคนต่อวินาที ซึ่งเป็นจุดที่วิศวกรพอใจที่สุด อย่างไรก็ตาม GLM รองรับแค่ข้อความ ไม่เหมาะกับงาน UI บริษัทจึงใช้ตัวจัดเส้นทางส่งงานที่ต้องใช้ภาพไปให้ Gemini หรือ GPT Luna ส่วนงานเขียนโค้ดยังให้ GLM รับผิดชอบต่อไป
ที่มาของข่าว
- สำนักข่าว
- The Register
- พาดหัวต้นฉบับ
- British fintech Revolut slashes AI coding costs 10x by cutting out Claude and going self-hosted
- เผยแพร่ต้นทาง
- 4 พ.ย. 2569 03:07 น.